IA générative en entreprise : par où commencer sans se tromper
Assistants internes, analyse de documents, service client : l'IA générative ouvre des possibilités réelles, à condition de choisir les bons cas d'usage et de maîtriser ses limites. Notre méthode pour passer de l'expérimentation à un usage fiable et sécurisé.
Sommaire 11 sections
- Ce que l'IA générative sait faire, et ce qu'elle ne sait pas faire
- Identifier les bons cas d'usage
- Choisir l'approche technique
- Le prompt engineering
- La génération augmentée par la recherche (RAG)
- Le fine-tuning
- Modèle hébergé par un fournisseur ou modèle déployé chez vous ?
- Données, confidentialité et conformité
- Mesurer la qualité avant de déployer
- Une démarche en quatre étapes
- Conclusion
Les modèles de langage ont fait entrer l'intelligence artificielle dans le quotidien de nombreuses équipes. Beaucoup d'organisations se posent désormais la même question : comment passer de l'usage individuel et informel d'outils grand public à des solutions fiables, intégrées aux processus de l'entreprise et respectueuses de la confidentialité des données ?
Voici la démarche que nous appliquons avec nos clients.
Ce que l'IA générative sait faire, et ce qu'elle ne sait pas faire
Un grand modèle de langage (LLM) excelle dans la manipulation du langage : résumer, reformuler, traduire, classer, extraire des informations d'un texte, rédiger un premier jet ou répondre à une question à partir de documents fournis.
Il présente en revanche des limites qu'il faut connaître avant tout projet :
- Il peut produire des informations fausses avec une grande assurance (on parle d'« hallucinations »), en particulier lorsqu'on l'interroge sur des faits qu'il ne connaît pas.
- Il ne connaît pas vos données : ni vos procédures, ni vos produits, ni vos clients, sauf si on les lui fournit.
- Ses réponses varient : deux questions identiques peuvent produire deux réponses différentes.
- Il ne remplace pas un calcul ou une règle métier : pour un montant, une date limite ou une décision réglementaire, un traitement déterministe reste indispensable.
Identifier les bons cas d'usage
Un bon cas d'usage combine une valeur métier claire, un volume suffisant et un risque maîtrisé en cas d'erreur. Le tableau suivant illustre des exemples fréquents :
| Cas d'usage | Valeur attendue | Niveau de risque |
|---|---|---|
| Assistant interne sur les procédures et la documentation | Gain de temps pour retrouver l'information | Faible à moyen |
| Tri et résumé des demandes entrantes (e-mails, tickets) | Traitement plus rapide, meilleure orientation | Faible |
| Extraction d'informations dans des factures ou contrats | Moins de saisie manuelle | Moyen : contrôle humain recommandé |
| Rédaction assistée de réponses au service client | Réponses plus rapides et homogènes | Moyen : validation avant envoi |
| Réponse automatique aux clients sans supervision | Disponibilité permanente | Élevé : périmètre à encadrer strictement |
Nous recommandons de commencer par des usages internes, où un humain reste dans la boucle, avant d'exposer l'IA directement à vos clients.
Choisir l'approche technique
Le prompt engineering
C'est l'approche la plus simple : on améliore les instructions données au modèle (rôle, contexte, format de réponse attendu, exemples). Elle suffit pour de nombreux usages de reformulation ou de classification.
La génération augmentée par la recherche (RAG)
Pour qu'un assistant réponde à partir de vos documents, on utilise le plus souvent une architecture RAG (Retrieval-Augmented Generation). Le principe :
- Vos documents sont découpés en passages et indexés dans une base de recherche, souvent vectorielle.
- À chaque question, le système retrouve les passages les plus pertinents.
- Le modèle rédige sa réponse à partir de ces passages uniquement, en citant ses sources.
Cette approche réduit fortement les hallucinations, permet de mettre à jour la connaissance sans réentraîner le modèle et offre une traçabilité précieuse : l'utilisateur peut vérifier la source de chaque réponse.
Le fine-tuning
Le fine-tuning consiste à réentraîner partiellement un modèle sur vos propres exemples. Il est utile pour imposer un style, un format ou un vocabulaire très spécifique, mais il est plus coûteux et n'est pas la bonne solution pour « apprendre » des connaissances qui évoluent. Dans la majorité des projets d'entreprise, le RAG est à privilégier en premier.
Modèle hébergé par un fournisseur ou modèle déployé chez vous ?
| Critère | API d'un fournisseur | Modèle ouvert auto-hébergé |
|---|---|---|
| Mise en œuvre | Rapide | Plus exigeante (serveurs, GPU, exploitation) |
| Qualité des réponses | Généralement la plus élevée | Variable selon le modèle et la tâche |
| Confidentialité | Dépend des engagements contractuels du fournisseur | Les données ne quittent pas votre infrastructure |
| Coût | À l'usage, proportionnel au volume | Fixe (infrastructure), intéressant à fort volume |
Le choix dépend avant tout de la sensibilité des données traitées. Une architecture bien conçue permet d'ailleurs de changer de modèle sans réécrire l'application.
Données, confidentialité et conformité
C'est le point sur lequel les organisations prennent le plus de risques sans le savoir. Quelques règles essentielles :
- Classer les données avant de les soumettre à un modèle : publiques, internes, confidentielles, personnelles.
- Vérifier les conditions contractuelles du fournisseur : conservation des requêtes, utilisation pour l'entraînement, localisation du traitement.
- Respecter les droits d'accès : un assistant interne ne doit jamais révéler à un employé un document qu'il n'a pas le droit de consulter. Le filtrage doit se faire au moment de la recherche des passages.
- Encadrer les usages par une charte interne : quels outils sont autorisés, pour quelles données.
- Suivre l'évolution réglementaire : la protection des données personnelles s'applique pleinement, et des textes spécifiques à l'IA, comme le règlement européen sur l'intelligence artificielle, encadrent désormais certains usages.
Mesurer la qualité avant de déployer
Un projet d'IA générative ne se valide pas en testant trois questions. Nous constituons avec nos clients un jeu d'évaluation : plusieurs dizaines de questions réelles, accompagnées des réponses attendues et des documents sources. Ce jeu permet de :
- mesurer objectivement la pertinence et l'exactitude des réponses ;
- comparer plusieurs modèles ou plusieurs réglages ;
- vérifier qu'une modification n'a pas dégradé la qualité (test de non-régression).
En production, un bouton de retour (« réponse utile / non utile ») et l'analyse des questions sans réponse permettent d'améliorer continuellement le système.
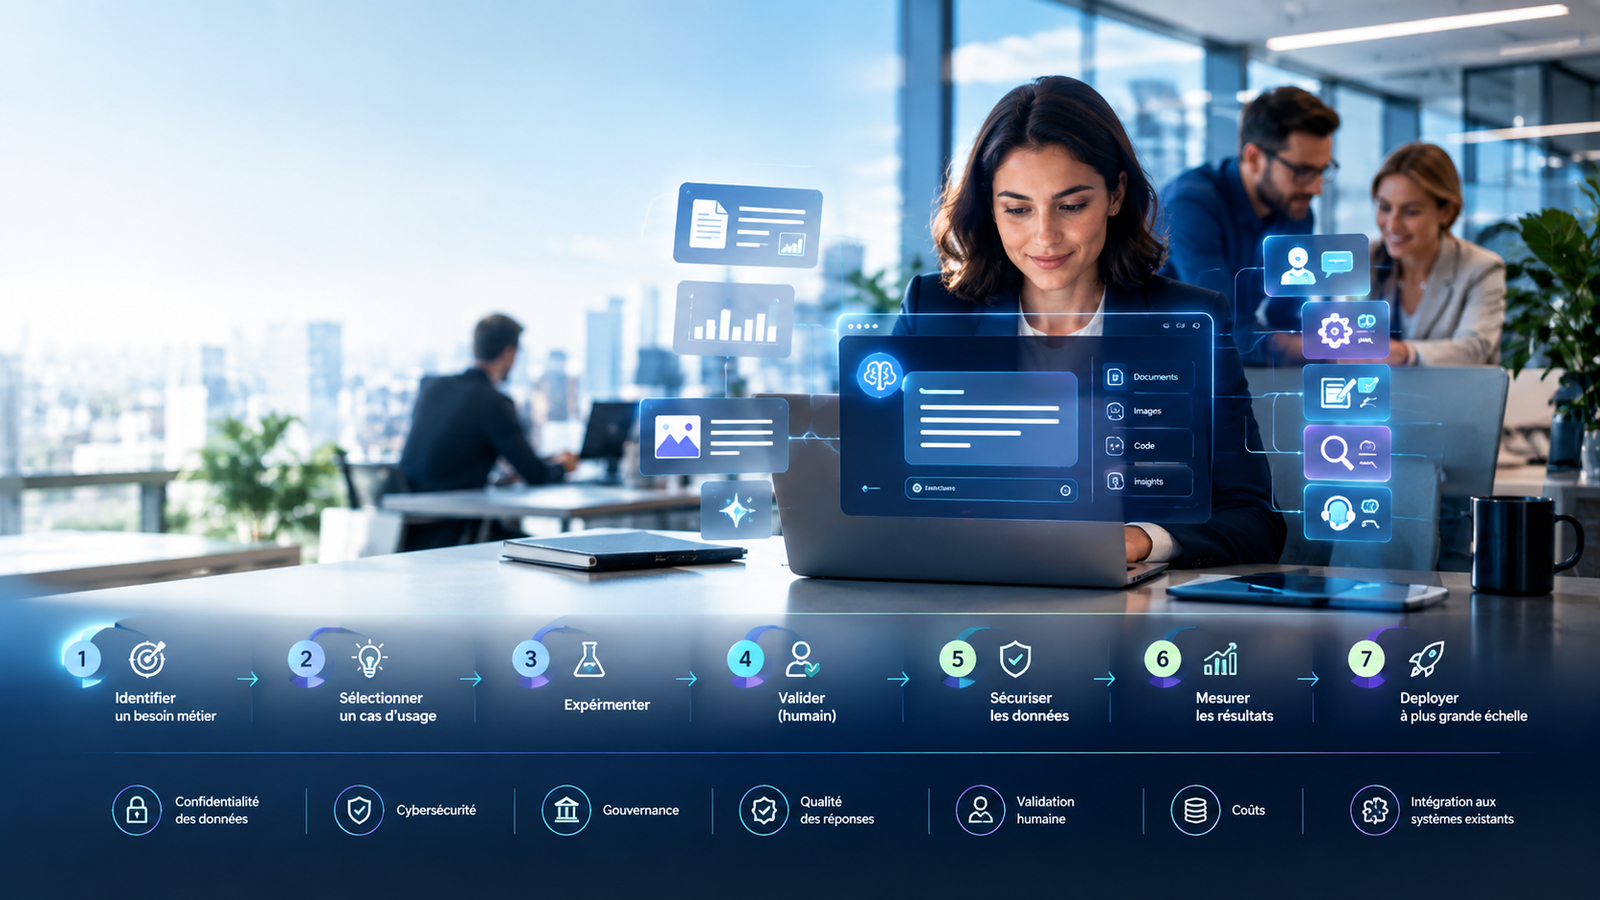
Une démarche en quatre étapes
- Cadrage : identifier deux ou trois cas d'usage prioritaires, évaluer les données disponibles et les risques.
- Prototype : construire en quelques semaines une première version sur un périmètre restreint, avec un groupe d'utilisateurs pilotes.
- Évaluation : mesurer la qualité, le temps gagné et l'adhésion des utilisateurs à l'aide du jeu d'évaluation.
- Industrialisation : sécurité, gestion des droits, supervision des coûts, intégration aux outils existants et formation des équipes.
La réussite d'un projet d'IA générative dépend moins du choix du modèle que de la qualité des données, de la clarté du cas d'usage et de la rigueur de l'évaluation.
Conclusion
L'IA générative n'est ni une baguette magique ni un simple effet de mode. Utilisée sur des cas d'usage bien choisis, avec vos données et des garde-fous adaptés, elle permet de libérer du temps sur des tâches à faible valeur ajoutée et d'améliorer l'accès à l'information. La clé est de commencer petit, de mesurer, puis d'étendre ce qui fonctionne.